
公司想用大型AI協助改程式、讀文件,除了向雲端買服務,現在多了一條值得評估的路:讓模型在自己的工作站運行。Meta於10月15日釋出Muse Spark Open開放權重,Apple同日示範以多台M5 Ultra Mac Studio執行這個8160億參數模型。
技術上能搬回來,財務上是否划算,還要看工作量與維運。對資料必須留在自管環境、任務穩定的團隊,本地部署有吸引力;對偶爾使用、需求忽高忽低的企業,雲端按量付費仍有優勢。理解這次合作,可以從「放得下、跑得動、值得買」三件事往下看。
3 個重點先看
- 大模型分工跑:稀疏架構降低每次計算量,量化與多機協作處理龐大記憶體需求。
- 速度有測試條件:四台每秒超過36個Token,來自特定精度、上下文與單序列測試。
- 省錢看整筆帳:採購攤提、電力、維運與有效使用量,都要和API費用一起比較。
一、8160億參數,為什麼每次只啟用一部分?
參數可以想成模型學習後留下的數值設定。Muse Spark Open採用混合專家架構(MoE),類似一個人數龐大的專家團隊,每次處理資料時,由系統選出部分專家參與工作。依Meta公布的規格,總參數約8160億,每個Token啟用約420億。
這讓每一步不必動用全部參數,降低推論計算需求;但其他專家仍是模型的一部分,完整權重還是得有地方存放。「每次只用一部分」與「只要準備一小部分記憶體」是兩回事。Token則是模型處理文字等資料的單位,不能固定換算成一個中文字。
Meta也公布100萬Token上下文規格,可把它理解成一次工作能帶進多少資料。這項容量和模型讀取資料的速度、回答品質,各自需要驗證。
二、兩台工作站,怎麼放下同一個模型?
要把大型模型搬到桌面,先過記憶體這一關。Apple研究指出,以原生BF16精度儲存,光模型參數就需要超過1.6TB記憶體;改成NVFP4量化格式,Apple該部署版本的模型占用降到約493GB,運行時還要留額外空間。
量化就像用較少位數記錄數值,換取較低的儲存需求;是否影響自己的任務品質,仍要實測。Apple Silicon的統一記憶體能由CPU與GPU共用,每台M5 Ultra Mac Studio最高512GB,但單台仍放不下這個模型完整運行時的需求。
其中一種解法,是把模型前半層放在第一台、後半層放在第二台:第一台算完,將中間結果傳給第二台接手。這稱為流水線平行(pipeline parallelization)。MLX負責分配與執行,再透過Thunderbolt的低延遲連線協作。
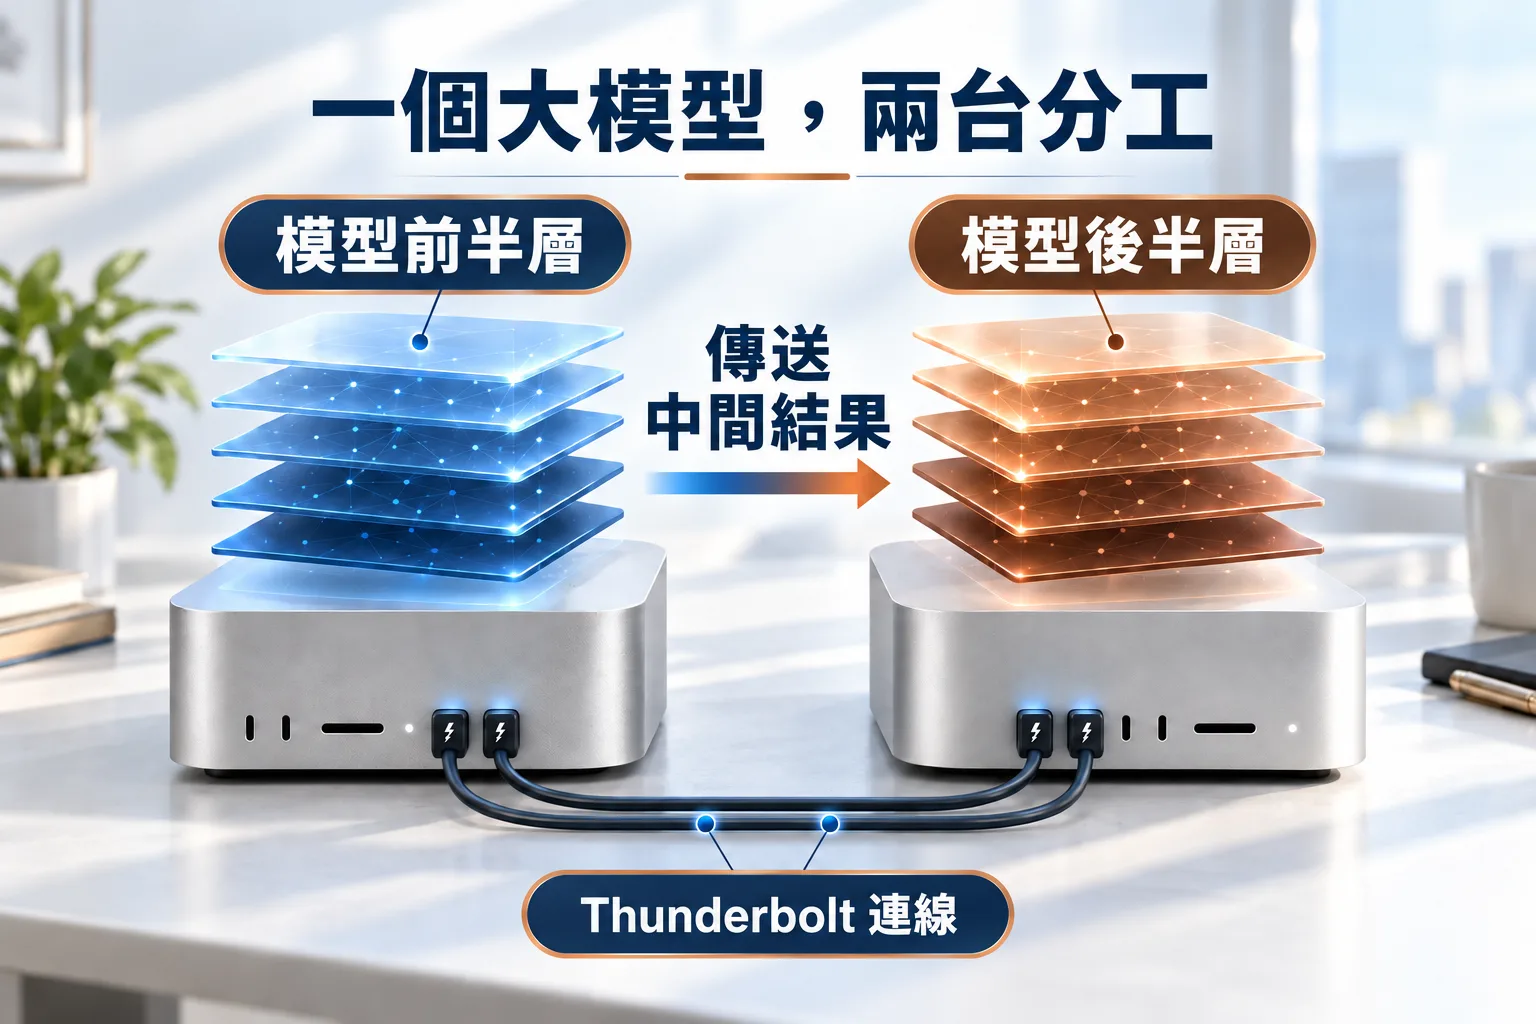
Apple也測了張量平行(tensor parallelization),把每一層的運算再拆給不同機器一起做。它能加快計算,也更依賴頻繁而快速的機間通訊。因此,多台工作站合作需要相應軟體與互連設定。
採購時另有時間差:Apple先前公告512GB版本預定10月下旬供貨。10月15日的研究展示,和企業能否立即買齊同規格設備,必須分開看。
三、每秒36個Token,能讓多少人用?
Apple公布的四台測試達每秒36.73個Token。這是開始生成後的速度,前面還有讀取輸入、等第一個Token出現的時間。兩個數字放在一起,才比較接近使用者會感受到的等待。
以下皆為M5 Ultra、NVFP4、8,192 Token上下文、單序列且生成128 Token的測試:
| 配置 | 首Token等待 | 生成速度 |
|---|---|---|
| 兩台/流水線 | 8.4秒 | 15.74 Token/秒 |
| 兩台/張量 | 8.2秒 | 24.99 Token/秒 |
| 四台/張量 | 4.8秒 | 36.73 Token/秒 |
多加機器確實提高了這組測試的生成速度,但表格沒有回答「20位同事同時發問會等多久」。更長文件、多人排隊、工具呼叫與失敗重試,會改變完整任務耗時。100萬Token是模型的上下文規格,36.73則是8,192 Token條件的測試,兩者不能拼成「百萬上下文也有同樣速度」。
企業試用時,應記錄每個任務的成功率、總等待時間與同時服務人數,再決定需要兩台、四台,或保留雲端處理尖峰需求。
四、自建與雲端,這筆帳怎麼算?
先拿同一份工作清單,再比較完成它的帳單。文件長度、回答品質與可接受的等待時間,都要對齊。雲端租GPU,是自行部署、按資源與時間付費;買API則由服務商運行模型、按用量計價。以下以同模型API作對照。
依10月16日查閱的OpenRouter頁面,Muse Spark Open每百萬未快取輸入Token為1.25美元、輸出為4.25美元。假設每月有1000萬輸入、200萬計費輸出Token,模型推論費就是10×1.25+2×4.25=21美元。輸出包含按平台計費的推理Token;儲值手續費、稅與額外工具服務另計。
21美元是這組用量的API試算。本地端還要拿到符合部署需求的報價,並確認設備能完成同一批工作。本文未取得512GB版本的完整採購報價,先看兩邊的成本構成:
| 項目 | 雲端API | 自有工作站 |
|---|---|---|
| 前期支出 | 按量使用,通常不必另購模型伺服器。 | 主機、互連與建置費先付,再按使用期間分攤。 |
| 運行成本 | 輸入與輸出用量乘費率,加適用的附加費。 | 設備月攤,加電費、維運、備援與更新預算。 |
| 用量變化 | 少用少付;尖峰受供應商容量與方案限制。 | 閒置也有設備成本;忙時要有足夠服務能力。 |
設備月攤可用「設備與建置支出減預估殘值,再除以使用月數」估算;採購現金仍在前期支付。電費要量測整套耗電,維運也要計入人力,開放權重免費下載不等於免費運行。
最後,把兩邊成本換成「完成一件合格任務要花多少錢」。測試應含讀取、推理、工具操作、重試與排隊,才能同時核對產出和總等待時間。
偶爾使用或需求起伏大的團隊,按量付費能少背閒置成本;工作穩定、已有合用設備或需要自管資料的團隊,則有評估本地部署的理由。是否更省,就用這份工作清單、報價與實測結果回答。
五、Apple、Meta與雲端,各自賺哪一段?
Apple(AAPL)主要收設備款。MLX替高記憶體Mac增加運行大型模型的用途。若帶來新增採購或高規格選購,就能增加硬體收入;獲利則取決於售價及硬體、研發與銷售等成本。
Meta(META)擴大模型的使用範圍。開放權重能進入更多開發者工具與硬體環境,本文將此解讀為分發價值。企業在自有機器內用,不因此按推論次數向Meta付費;Muse Model License仍要求符合門檻的對外模型API服務另簽協議。使用擴大之後,收入還要看商業安排。
雲端服務商收的是用量或容量費。Muse Spark Open同時也在雲端供應,Baseten就提供按量API及專用推論部署。客戶付費取得可用算力、代管與擴容彈性,服務商則負擔算力、電力與維運成本。因此,本地部署增加選擇,也讓雲端更需要用價格、穩定性與服務能力留住客戶。
後續可追蹤同規格設備報價與供貨、真實任務能服務多少人,以及企業是否增加採購或調整雲端支出。大型AI搬回辦公室後,企業要算的是:為了完成自己的工作,哪些能力買下來、哪些按需付費最合適。
怎麼買Meta(META)、Apple(AAPL)?
想投資Meta(META)、Apple(AAPL)?
線上 5 分鐘快速申請查看手續費優惠詳情 ▼
*APP 存股手續費 0.08% (低消 0.1 美元)*
點此看更多開戶活動優惠
*美股優惠期間至 2026/12/31,新戶適用,實際以官方公告為準。
小提醒:美股採「圈存」制,下單前請確認餘額!



